

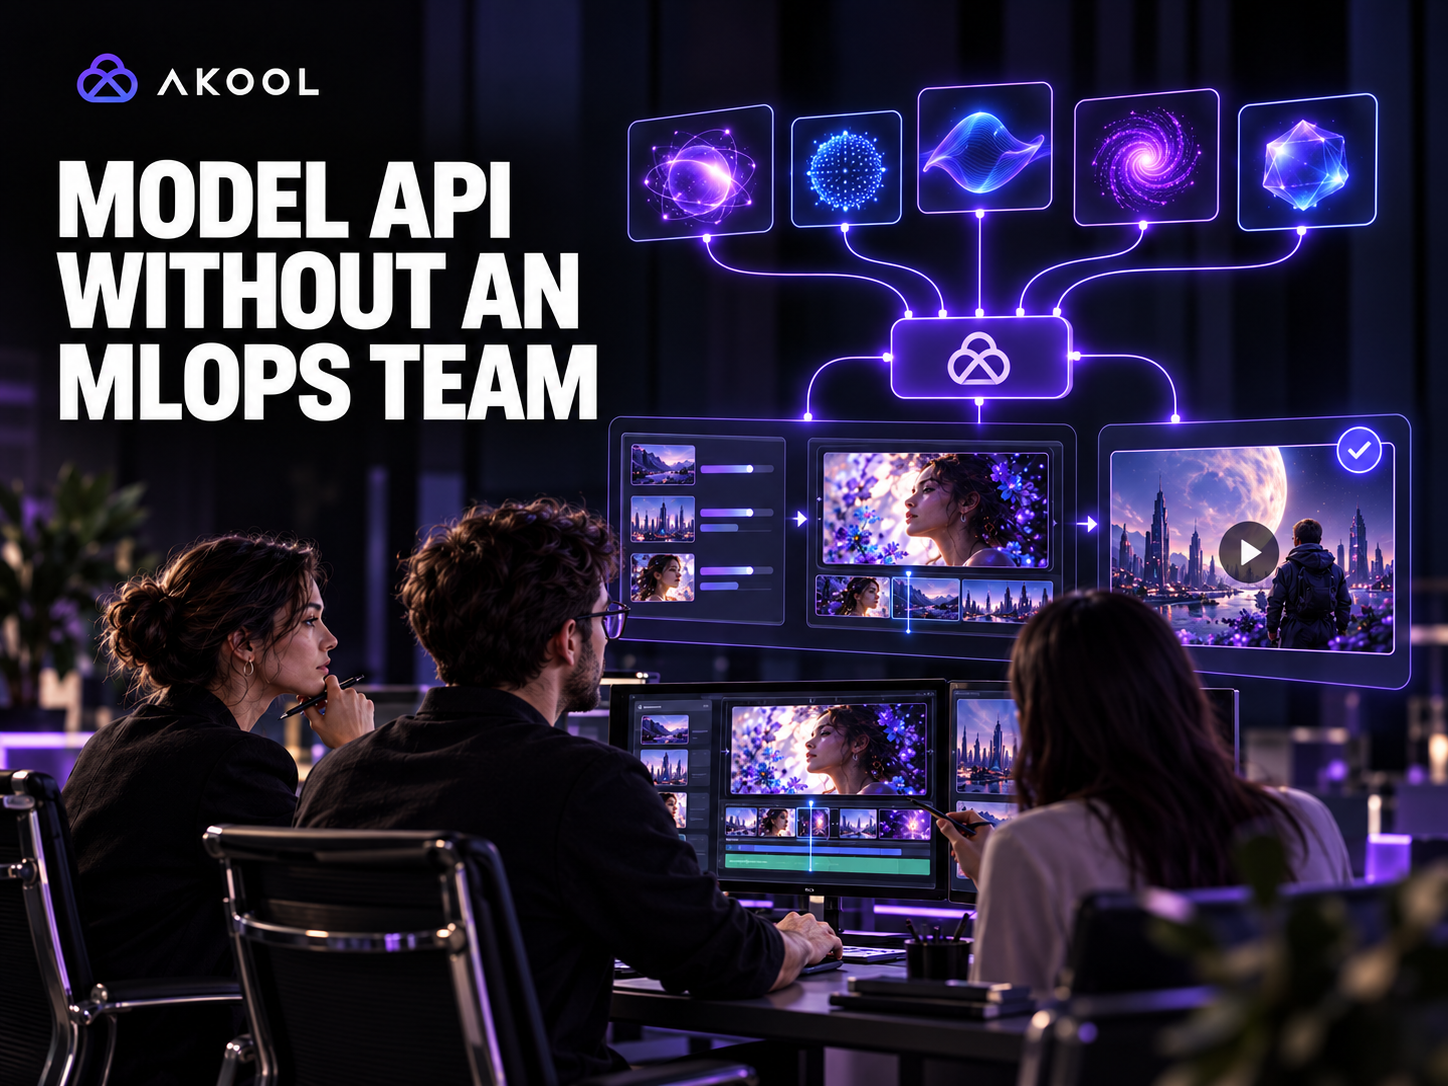

Oui. Une API d'agrégation de modèles permet à une équipe produit d'utiliser plusieurs options de génération vidéo par IA sans avoir à héberger les poids des modèles, à maintenir une infrastructure GPU ou à créer une pile de déploiement distincte pour chaque modèle. Cela ne supprime pas le travail d'ingénierie, mais déplace les efforts de l'équipe des opérations liées aux modèles vers l'intégration produit, le routage, le contrôle qualité et la maîtrise des coûts.
AKOOL fournit une interface API unifiée pour découvrir les modèles de génération disponibles et créer des tâches multimédias. Le point de terminaison du modèle d'IA renvoie les configurations actuelles des modèles par type de tâche, notamment image-vers-vidéo et texte-vers-vidéo. L'application peut utiliser ce catalogue pour proposer les choix pris en charge sans coder en dur une liste qui deviendrait rapidement obsolète.
Ce qu'une API d'agrégation de modèles remplace réellement
Sans couche API gérée, une équipe doit souvent provisionner des accélérateurs, packager les environnements d'exécution des modèles, gérer les dépendances, surveiller la mémoire et le débit, planifier les tâches, stocker les résultats, mettre à jour les versions et maintenir une intégration différente pour chaque moteur de génération.
Une couche d'agrégation gérée peut fournir :
- un modèle d'authentification et de compte unique ;
- un catalogue consultable des options de génération prises en charge ;
- des modèles de soumission de tâches normalisés ;
- une inférence hébergée et une gestion de la capacité ;
- des mécanismes de récupération des résultats et de rappel (callback) ;
- des contrôles partagés de crédit, d'utilisation et opérationnels ;
- une méthode pour ajouter ou mettre à jour des modèles sans reconstruire toute l'application.
L'équipe produit conserve la maîtrise de l'expérience utilisateur, des autorisations sur les ressources sources, de la construction des prompts, de la politique de routage, des contrôles qualité, du stockage et des décisions de publication.
Une architecture légère
Utilisez un petit service applicatif entre l'interface utilisateur et AKOOL.
- Le client envoie une demande de création authentifiée à votre backend.
- Le backend valide les autorisations, les URL des médias, la tâche demandée et le budget.
- Le service lit ou actualise le catalogue des modèles pris en charge pour cette tâche.
- Une règle de routage sélectionne une configuration approuvée ou présente un choix contrôlé.
- Le backend soumet la tâche de génération et stocke l'identifiant renvoyé.
- Un worker surveille la tâche ou reçoit un rappel (callback).
- Le résultat entre dans une file d'attente de révision avant d'être copié vers un stockage durable ou publié.
Cette architecture peut fonctionner dans une pile d'applications web classique. Elle ne nécessite pas d'équipe dédiée à la gestion des poids des modèles, mais exige tout de même une responsabilité claire pour l'intégration de l'API et les opérations créatives.
Étape 1 : Découvrir les modèles de manière dynamique
L'API de modèles IA d'AKOOL accepte un ou plusieurs types de tâches et renvoie des objets de configuration de modèle. Utilisez-la pour alimenter un catalogue interne plutôt que de considérer une feuille de calcul gérée manuellement comme source de vérité.
Mettez en cache la réponse pour une période raisonnable, enregistrez la date de rafraîchissement et gérez l'indisponibilité éventuelle d'un modèle. Ne proposez pas automatiquement toutes les options renvoyées. Maintenez un sous-ensemble approuvé pour chaque flux de travail produit jusqu'à ce que l'équipe ait testé ses entrées, ses sorties, sa latence et son coût.
Étape 2 : Router selon les exigences du flux de travail
Évitez un commutateur vague de type « meilleur modèle ». Définissez des règles de routage basées sur la tâche :
- type d'entrée : texte, image ou média de référence pris en charge ;
- format d'image et résolution requis ;
- durée et exigences audio ;
- besoins en matière de cohérence de produit ou de personnage ;
- temps de traitement acceptable ;
- budget par sortie approuvée ;
- disponibilité de l'espace de travail ou du forfait.
Acheminez vers une valeur par défaut testée lorsque les exigences sont prévisibles. Ne donnez le choix aux utilisateurs avancés que lorsque les différences sont significatives et gérables.
Étape 3 : Soumettre une tâche normalisée
Créez un objet de requête interne qui représente les besoins de votre produit, puis mappez-le vers le point de terminaison et la configuration de modèle AKOOL. Pour la conversion image-vidéo, le courant Créer un point de terminaison Image vers Vidéo documente l'image source, le prompt, le prompt négatif, la résolution et d'autres champs de génération.
Conservez les identifiants API sur le backend. Validez les URL des médias et la propriété des fichiers avant la soumission. Enregistrez la requête interne, la configuration sélectionnée, l'identifiant de tâche du fournisseur, l'heure de création, l'utilisateur et le projet afin de pouvoir retracer le résultat ultérieurement.
Étape 4 : Gérer les résultats comme des tâches asynchrones
Les tâches de génération peuvent être mises en file d'attente, s'exécuter, échouer ou se terminer après la fin de la requête web initiale. Utilisez une table de tâches et un gestionnaire de workers ou de rappels plutôt que de maintenir la connexion client ouverte.
Rendez les rappels idempotents, appliquez une limite de tentatives et vérifiez la tâche d'origine avant d'en créer une nouvelle. Présentez des états de produit clairs tels que mis en file d'attente, en cours de génération, prêt pour examen, rejeté et approuvé. « Terminé » doit décrire la tâche technique, et non la décision éditoriale.
Étape 5 : Ajouter une couche d'examen et de stockage
Les médias générés peuvent modifier le texte, les logos, les visages, les détails des produits, les mouvements ou les affirmations implicites. Les critères d'examen doivent correspondre au flux de travail. Une vidéo produit peut privilégier la précision du SKU ; une scène avec des personnages peut privilégier l'identité et le consentement ; une publicité sur les réseaux sociaux peut privilégier un cadrage sécurisé, la clarté de l'accroche et un texte d'appel à l'action contrôlé.
AKOOL précise que les ressources API générées peuvent être temporaires pour certains points de terminaison. Copiez les résultats approuvés dans un stockage régi par vos propres politiques de conservation, d'accès et de suppression. Ne stockez les résultats rejetés que lorsqu'ils sont nécessaires à des fins d'évaluation ou d'audit.
Ce dont vous avez toujours besoin sans équipe MLOps
Une API unifiée allège considérablement la charge infrastructurelle, mais ne supprime pas la responsabilité opérationnelle. Attribuez la responsabilité de :
- clés API, contrôle d'accès et limites budgétaires ;
- configurations de modèles approuvées par flux de travail ;
- modèles de prompts et de références ;
- gestion des échecs et état visible par l'utilisateur ;
- normes de qualité et files d'attente d'examen ;
- conservation et suppression des actifs ;
- suivi de l'utilisation, de la latence, du taux d'approbation et du coût par résultat approuvé ;
- examen des modifications de l'API et des modèles avant le déploiement en production.
Ces responsabilités peuvent être intégrées à une équipe d'ingénierie produit et d'opérations créatives. L'essentiel est de maintenir une surface prise en charge délibérée plutôt que d'exposer toutes les options sans test préalable.
Plan pilote de deux semaines
Choisissez une tâche précise, comme transformer une image de produit approuvée en un court clip révisable.
Pendant le projet pilote :
- Définissez trois ressources sources représentatives et un modèle de prompt.
- Récupérez le catalogue actuel et approuvez un petit ensemble de configurations.
- Soumettez les tâches via une interface backend.
- Suivez le temps de file d'attente, l'achèvement, les échecs, les crédits et le résultat de la révision.
- Comparez les résultats en utilisant la même liste de contrôle d'acceptation.
- Documentez le comportement de secours lorsqu'une configuration n'est pas disponible.
- Approuvez uniquement les configurations qui répondent aux exigences de qualité et opérationnelles du flux de travail.
Mesurez le coût par résultat approuvé, et non seulement le coût par génération. Un résultat à faible coût qui est rejeté à plusieurs reprises n'est pas opérationnellement efficace.
En résumé
Une API d'agrégation de modèles permet à une équipe de créer des fonctionnalités vidéo basées sur l'IA sans avoir à gérer un parc de modèles de génération. AKOOL fournit la découverte de modèles et des points de terminaison de génération gérés ; votre application gère le routage, l'authentification, l'état des tâches, la révision, le stockage et la gouvernance. Commencez par une seule tâche, exposez un sous-ensemble testé et développez uniquement lorsque les données opérationnelles le justifient.
Explorez l'API des outils d'IA d'AKOOL et créez le prototype d'un flux de travail de génération contrôlé avant d'ajouter d'autres types de tâches.